
이혁준 교수팀 연구…국제학술대회 ‘EMNLP 2026’ 논문 채택
서강대학교 연구진이 불필요하거나 중복된 음성정보는 줄이고 음성인식에 필요한 핵심정보만 선별해 인공지능(AI)의 첫 응답시간을 24.8% 단축하는 기술을 개발했다. 처리해야 할 정보량을 줄이면서도 음성인식 성능 저하를 최소화한 것이 핵심이다.
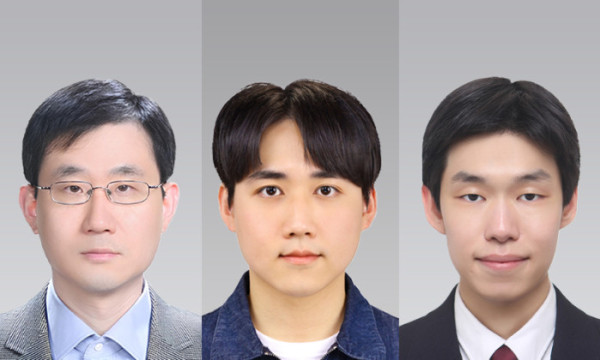
서강대는 컴퓨터공학과 이혁준 교수 연구팀의 이 같은 연구 결과가 자연어처리 분야 주요 국제학술대회인 ‘EMNLP 2026 Findings’에 채택됐다고 28일 밝혔다. 연구에는 정재한 석사과정이 제1저자로, 이태한 박사과정이 참여했으며 이 교수가 교신저자를 맡았다.
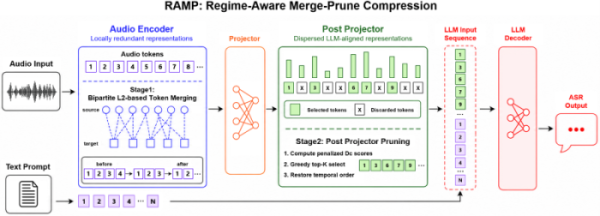
음성인식 AI는 사람이 말한 음성을 잘게 나눈 수많은 정보 단위인 ‘토큰’으로 바꿔 처리한다. 음성이 길어질수록 처리해야 하는 토큰이 많아져 연산량이 늘고 응답에도 더 많은 시간이 걸린다. 연구팀은 AI가 음성을 처리하는 초기 단계에서는 토큰 사이에 중복된 정보가 많은 반면, 이후 단계로 갈수록 정보가 분산되는 특성이 있다는 점에 주목했다.
연구팀은 이를 바탕으로 음성 처리 단계에 따라 정보량을 줄이는 방식을 달리하는 ‘RAMP’ 기술을 개발했다. 초기 단계에서는 비슷한 음성정보를 합쳐 처리해야 할 정보량을 줄이고, 이후 단계에서는 음성인식에 중요한 정보만 골라 남기는 방식이다. 모든 단계의 정보를 일률적으로 줄이는 대신 단계별 특성에 맞춰 압축 방식을 달리해 정보 손실을 줄였다.
특히 기존 AI 모델을 별도로 다시 학습시키거나 구조를 크게 바꾸지 않고도 적용할 수 있다. 연구팀은 이를 통해 AI가 처리해야 할 음성정보의 양을 줄여 실제 음성인식 과정에서 연산 효율을 높일 수 있다고 설명했다.
연구팀은 두 종류의 오디오·언어 AI 모델을 대상으로 7개 음성인식 성능평가를 진행했다. 그 결과 한 모델에서 전체 음성정보의 40%만 남겼을 때도 기존 압축 기법보다 음성인식 오류 증가 폭이 작았다. 특히 음성을 입력한 뒤 AI가 첫 응답을 내놓기까지 걸리는 시간은 압축하지 않은 기본 모델보다 24.8% 단축됐다.
연구팀은 이번 연구가 AI의 음성 처리 단계별 특성에 맞는 압축 방식을 적용해 음성인식 성능 저하를 줄이면서 추론 효율을 높였다는 데 의미가 있다고 밝혔다.