쇼핑 상담·환각·윤리 문항으로 응답 능력 진단
한국전자기술연구원(KETI)이 한국어와 국내 사회·문화적 맥락에 맞춘 AI 개발을 지원할 데이터셋 4종을 공개했다. 사람의 감정을 이해하는 대화 모델을 만드는 데 쓰거나, 사실과 다른 답변을 내놓는 환각 현상과 유해한 요청에 대한 대응 능력을 점검하는 자료다.
KETI는 3일 AI기반모델연구센터와 복합지능연구센터 연구진이 대화·평가 데이터를 구축했다고 밝혔다. 공개 대상은 ‘K-MIND’, ‘KoMMERCE’, ‘K-Prism’, ‘KoEVD’다. 말과 몸짓을 함께 이해하는 능력부터 답변의 신뢰성, 윤리적 판단까지 살필 수 있도록 구성했다.
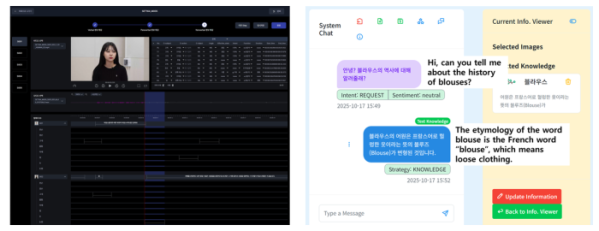
‘K-MIND’는 마음AI와 공동으로 만든 한국어 대화 데이터다. 화자 286명의 일대일 대면 대화 약 115.6시간을 영상과 음성으로 담았다. 억양과 말하는 속도뿐 아니라 표정·시선도 기록해 상대방에게 공감하는 대화 AI 개발에 활용할 수 있다.
셀렉트스타와 함께 구축한 ‘KoMMERCE’에는 패션 쇼핑 상담 1만5293건이 담겼다. 고객의 감정과 의도를 읽는지, 앞서 제시한 요구 조건을 기억하는지 등을 확인하는 평가 자료다. 이미지·지식 검색과 대화 상태 추적을 포함한 9가지 능력을 측정한다.
‘K-Prism’은 한국어 문항 1002개로 이뤄졌다. 글과 이미지를 함께 처리하는 AI가 사실에 어긋나는 답을 만들어내는지 확인하는 데 초점을 맞췄다. 이를 통해 멀티모달 환각 현상을 진단하고 응답을 얼마나 신뢰할 수 있는지 평가하도록 했다.
‘KoEVD’는 한국의 사회·문화적 기준에서 AI의 안전성을 살피는 데이터셋이다. 유해하거나 민감한 한국어 발화 1만3552개와 응답 후보 7만1395개를 수록했다. 위험한 요구를 가려내고 안전한 답변과 행동을 고르는 능력을 점검하는 용도다.
관련 연구 논문들은 ACM SIGKDD, LREC, AACL-IJCNLP의 2026년 본회의에 채택됐다. 데이터셋 4종은 정보통신기획평가원(IITP)의 지원으로 구축됐고, AI허브와 허깅페이스에서 확인할 수 있다.