체크포인트 쓰기 시간 변동 최대 43배 감소…슈퍼컴퓨터서 검증
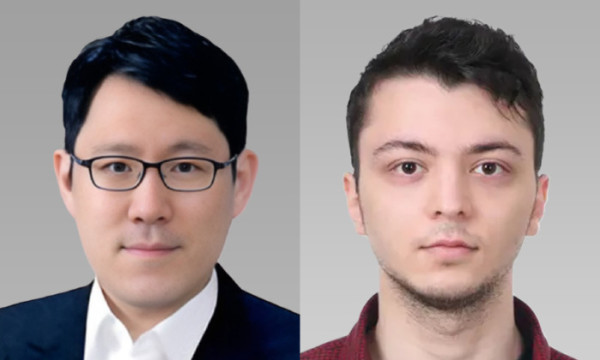
서강대학교 연구진이 대규모 인공지능(AI) 모델 학습 과정에서 시스템 장애로 인한 데이터 손실을 줄이고 저장 성능을 높이는 기술을 개발했다. 기존보다 체크포인트 저장 시간의 변동성을 최대 43배 낮춘 성과로, 세계 최고 권위의 AI 학술대회인 'NeurIPS 2026'에 논문이 채택됐다.
서강대는 컴퓨터공학과 김영재 교수 연구팀의 논문이 오는 12월 열리는 국제학술대회 'NeurIPS 2026'에 채택됐다고 12일 밝혔다.
이번 연구에는 서강대 데이터 중심 AI 컴퓨팅 및 시스템(DISCOS) 연구실의 김영재 교수와 Farid Talibli 박사과정 학생을 비롯해 미국 오크리지국립연구소(Oak Ridge National Laboratory) 소속 연구진 등이 참여했다. 김 교수는 교신저자, Talibli 학생은 제1저자로 이름을 올렸다.
1987년 시작된 NeurIPS는 머신러닝과 AI 분야의 대표적인 국제학술대회다. 올해 학회는 12월 6일부터 13일까지 호주 시드니와 미국 애틀랜타, 프랑스 파리에서 개최될 예정이다.
이번 논문의 핵심은 AI 학습 과정에서 저장된 데이터가 실제로 안전하게 보호되는 시점을 분석하고, 시스템 장애가 발생하더라도 이미 진행한 학습 결과를 최대한 보존할 수 있도록 하는 기술이다.
대규모 AI 모델 학습에는 막대한 컴퓨팅 자원과 시간이 투입된다. 학습 도중 장애가 발생하면 기존 작업을 다시 수행해야 하는 만큼 학습 진행 상황을 주기적으로 저장하는 '체크포인트(checkpoint)' 기술이 필수적이다.
그러나 기존 비동기 체크포인팅 방식은 데이터 저장 작업이 진행되는 동안에도 AI 학습을 계속할 수 있지만, 저장 작업이 완료된 것으로 표시되더라도 실제 데이터가 안전하게 보존됐다고 보장하기 어렵다는 한계가 있다. 이 과정에서 장애가 발생하면 이전 저장 시점으로 돌아가 학습을 반복해야 한다.
연구팀은 이러한 문제를 해결하기 위해 체크포인트 저장 과정을 네 단계로 구분하고, 데이터가 실제로 안전하게 저장되는 시점을 분석하는 확률분포 기반 모델을 개발했다.
특히 공유 파일시스템에 데이터를 직접 저장하는 방식과 다른 컴퓨팅 노드에 복제하는 방식을 비교해 시스템 환경에 따라 효율적인 저장 경로를 선택할 수 있도록 했다.
이를 구현하기 위해 연구팀은 새로운 스토리지 계층인 'CacheX'도 개발했다. CacheX는 체크포인트 데이터를 로컬 메모리에 먼저 저장한 뒤 다른 노드의 고속 저장장치(NVMe)에 복제하고, 이후 공유 파일시스템으로 전송하는 방식이다.
기존 AI 학습 프로그램의 코드를 수정하지 않고도 적용할 수 있다는 점이 특징이다. 공유 스토리지에 작업이 몰리는 상황에서도 별도 노드에 저장된 복제본을 활용해 데이터 손실 위험을 줄일 수 있다.
연구팀은 미국의 프런티어(Frontier) 슈퍼컴퓨터와 한국과학기술정보연구원(KISTI)의 뉴런(Neuron) 시스템 등을 활용해 성능을 검증했다.
실험 결과 CacheX는 평가 대상 작업에서 체크포인트 쓰기 시간의 변동계수를 최대 43배 감소시켰다. 이는 저장 작업에 걸리는 시간의 편차를 크게 줄여 보다 안정적인 성능을 확보했다는 의미다.
대규모 환경에서 일반적인 데이터 쓰기 작업의 완료 시간을 예측한 실험에서도 평균 절대 백분율 오차(MAPE) 7.1%를 기록했다.
실제 장애 상황을 가정한 실험에서도 복구 가능성을 확인했다. 연구팀은 체크포인트 메타데이터를 관리하는 호스트의 학습 프로세스를 강제로 종료하고 해당 호스트에 저장된 데이터를 삭제했다. 공유 파일시스템을 통한 복구 기능까지 차단했지만, 다른 노드에 복제된 데이터를 활용해 32개의 체크포인트 데이터 조각과 메타데이터를 복원하고 AI 학습을 정상적으로 재개하는 데 성공했다.
이번 연구는 AI 학습 과정에서 데이터 저장에 걸리는 시간을 줄이는 것뿐 아니라 장애 발생 시 실제로 손실될 수 있는 학습 진행량까지 고려해야 한다는 점을 제시했다는 데 의미가 있다.
연구팀은 이를 통해 대규모 AI 학습 시스템의 안정성과 장애 복구 효율을 높이는 데 기여할 수 있을 것으로 기대하고 있다.