
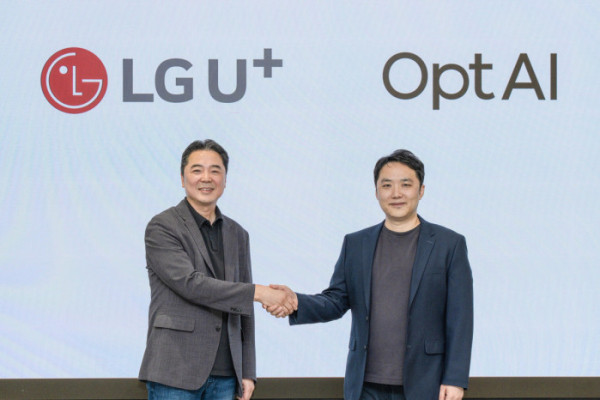
LG유플러스가 AI 모델 최적화 전문기업 옵트에이아이와 손잡고 AI 운영 효율을 높이는 토큰 최적화 기술 확보에 나선다. 그래픽처리장치(GPU)와 전력 등 AI 서비스 운영에 필요한 비용이 늘어나고 있어 같은 수준의 서비스를 더 적은 자원으로 제공하는 기술의 중요성이 커졌기 때문이다.
LG유플러스와 옵트에이아이는 AI 운영 효율을 높이는 ‘토큰 최적화’ 기술 확보에 나선다고 2일 밝혔다. 토큰은 AI가 이용자의 질문을 이해하고 답변을 생성할 때 처리하는 데이터의 기본 단위다. 토큰 최적화는 AI 모델을 가볍게 만들거나 연산 과정을 효율화해 같은 자원으로 더 많은 요청을 처리할 수 있도록 하는 기술이다.
LG유플러스는 실제 AI 서비스 운영 경험을 바탕으로 기술 검증과 적용을 담당하고, 옵트에이아이는 AI 모델을 더 가볍고 빠르게 구동하는 기술 연구와 개발을 맡는다. 양사가 보유한 역량을 결합해 AI 서비스 운영에 필요한 GPU와 전력 사용량을 줄이면서도 응답 속도와 서비스 품질을 높이는 것이 목표다.
양사는 그동안 스마트폰 등 기기 자체에서 AI를 구동하는 온디바이스 AI 분야에서도 협력해왔다. LG유플러스는 ‘엑사원(EXAONE)’ 기반 소형언어모델(sLM)에 모델의 연산량과 크기를 줄이는 경량화 기술을 적용해 스마트폰의 AI 전용 반도체인 신경망처리장치(NPU)에서 구동할 수 있도록 했다. 기존 중앙처리장치(CPU) 방식과 동일한 수준의 성능을 유지하면서 전력 소모는 78%, 모델 크기는 82% 줄였다. 이를 통해 양사는 온디바이스 AI 환경에서 AI 운영 효율화 기술 역량을 검증한 바 있다.
양사는 1일 AI 운영 효율화 기술의 최신 연구 동향과 산업 적용 사례를 공유하는 ‘Efficient AI 테크 세미나’도 공동 개최하고 AI 운영 효율 향상을 위한 기술 발전 방향을 논의하기도 했다. 행사에는 AI 반도체 기업 퓨리오사AI, AI 플랫폼 기업 베슬에이아이(VESSL AI), 한국전자기술연구원(KETI), 한양대학교 등 산·학·연 전문가들이 참여해 AI 모델 최적화부터 AI 반도체, 실제 서비스 적용에 이르기까지 AI 운영 효율을 높이기 위한 다양한 기술과 사례를 공유했다.
양사는 이번 기술 교류를 계기로 서버 GPU 환경까지 공동 연구 범위를 확대한다. 대규모 AI 서비스를 운영할 때 같은 GPU 자원으로 더 많은 이용자의 요청을 처리할 수 있도록 AI 모델의 연산 과정을 효율화하는 기술을 중점적으로 연구할 계획이다.
현재 진행 중인 GPU 기반 AI 모델 최적화 연구에서도 초기 성과가 나타나고 있다. 양사는 AI 모델이 답변을 생성하는 연산 과정을 실제 서비스 환경에 맞게 개선해 같은 GPU에서 처리할 수 있는 토큰량을 기존 대비 최대 네 배 높이는 성과를 거뒀다.
LG유플러스는 향후 확보한 기술을 자사 AI 서비스와 대규모 AI 인프라 운영 환경에 단계적으로 적용하며 AI 운영 효율을 지속적으로 높여 나갈 계획이다.
이상엽 LG유플러스 최고기술책임자(CTO)는 “AI 경쟁력은 단순히 성능을 높이는 것을 넘어 같은 자원으로 얼마나 많은 토큰을 효율적으로 처리할 수 있느냐에 달려 있다”며 “옵트에이아이를 비롯한 다양한 파트너들과 협력해 토큰 최적화 기술 연구를 확대하고 실제 서비스에 적용할 수 있는 성과를 만들어 나가겠다”고 말했다.
이재호 옵트에이아이 대표는 “생성형 AI 시대에는 높은 성능만큼이나 운영 효율을 확보하는 것이 중요해지고 있다”며 “LG유플러스와 함께 실제 서비스 환경에서 검증 가능한 AI 최적화 기술을 고도화하고 AI 산업의 효율성 향상에 기여하겠다”고 밝혔다.